ИИ-контент для SEO и GEO: как использовать нейросети без вреда для трафика и репутации
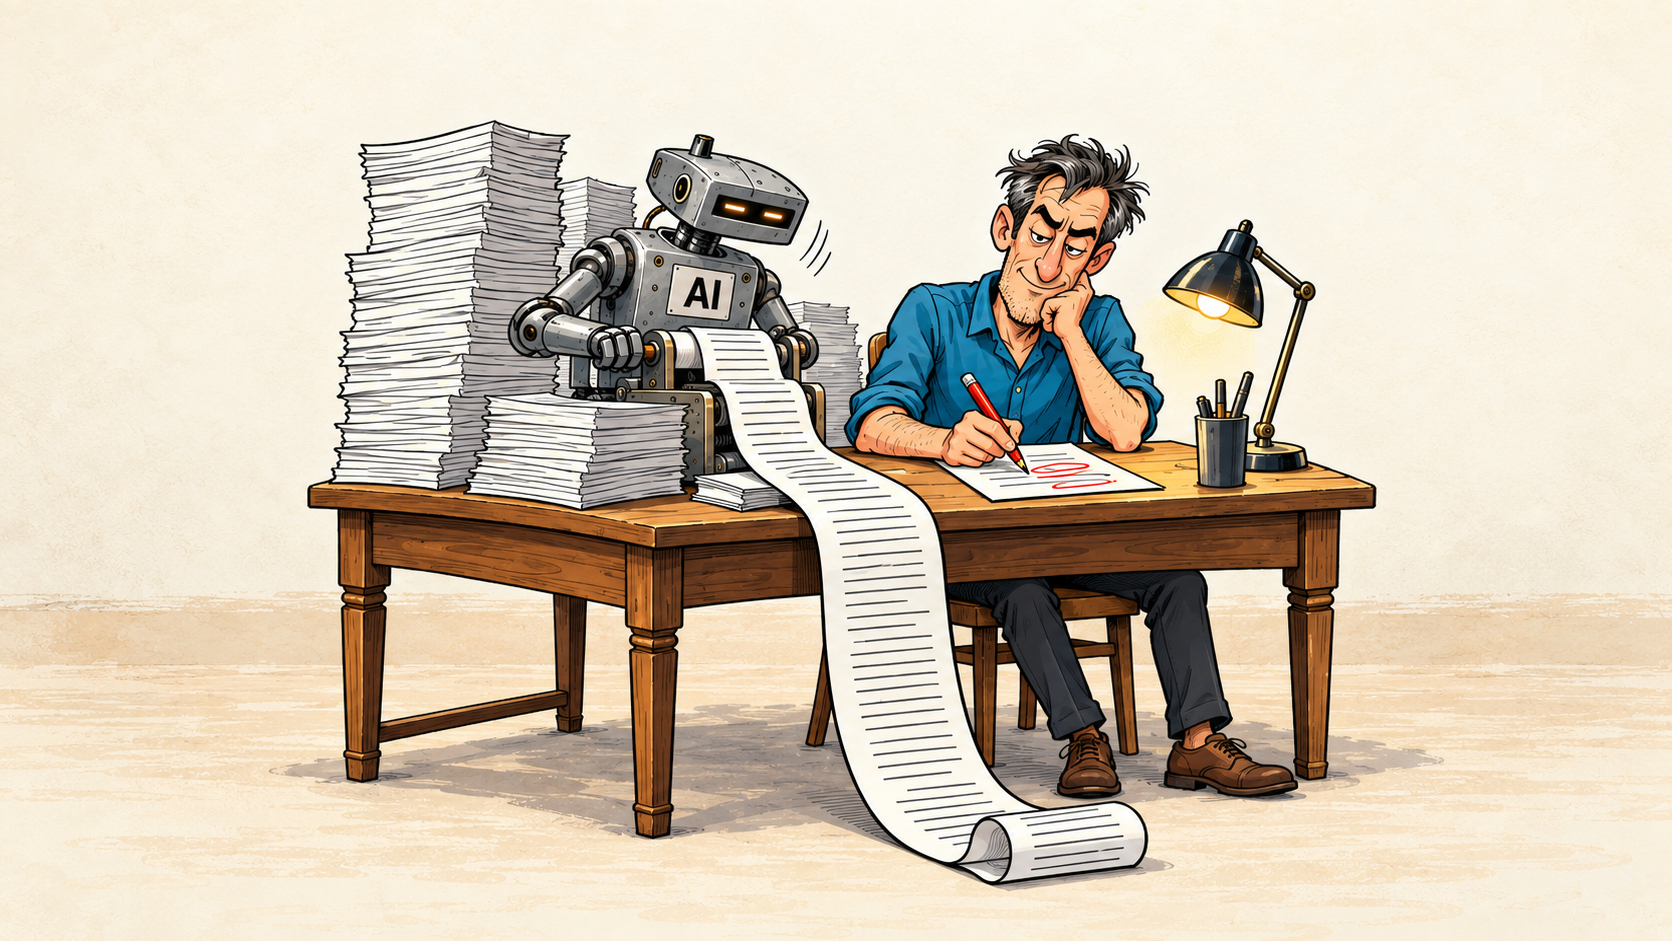
Нейросеть действительно способна выдать статью за минуту. За ту же минуту она может придумать статистику, сослаться на несуществующее исследование, собрать бинго из банальностей и упаковать всё это так, будто перед вами экспертный материал.
Проблемы начинаются не с покупки подписки на ИИ, а в тот момент, когда сырой черновик отправляют в прод как готовую публикацию.
Языковые модели отлично ускоряют ресерч, помогают обрабатывать данные, собирать структуру и находить логические дыры. Но они не заменяют сеньор-редактора, отраслевого эксперта и человека, который отвечает за опубликованные факты.
Разберёмся, как выстроить работу с нейросетями для SEO- и GEO-контента, чтобы они экономили время и бюджет, а не превращали сайт в конвейер шаблонных текстов, которые не нужны ни пользователям, ни поисковым системам, ни ИИ.
Запрещает ли Google контент, созданный с помощью ИИ?
Короткий ответ: нет, само использование ИИ не является нарушением.
Google оценивает не то, как создан текст, а его качество, достоверность и пользу для пользователя. В SEO это называют Information Gain: материал должен сообщать что-то новое, а не пересказывать топ выдачи другими словами.
Само использование ИИ не даёт преимуществ в ранжировании. Бонуса за то, что текст написан через API самой дорогой модели, не будет.
Позиция Google сводится к трём пунктам:
- Контент, созданный с помощью ИИ, допустим. Важно не происхождение текста, а его качество и назначение.
- ИИ сам по себе не является фактором ранжирования. Алгоритмы не выдают дополнительные баллы ни человеку, ни нейросети.
- Массовое производство страниц ради манипулирования выдачей считается спамом. Неважно, написал их ИИ, дешёвый копирайтер или очень уставший стажёр.
В антиспам-политике Google это классифицируется как злоупотребление масштабированным контентом. Способ создания вторичен: проблему создаёт массовый выпуск страниц без самостоятельной ценности, предназначенных прежде всего для манипулирования поисковыми результатами.
Риск не в кнопке «Сгенерировать», а в попытке взять выдачу количеством, забыв про задачу пользователя.
Что важно знать об E-E-A-T в эпоху GEO
E-E-A-T — опыт, экспертность, авторитетность и достоверность — часто продают как прямой фактор ранжирования: повесил плашку с автором, добавил несколько ссылок, разметил страницу — и полетел в топ.
Это дилетантское упрощение. Google прямо указывает: E-E-A-T не является отдельным фактором ранжирования. Это фреймворк, который помогает оценивать качество и достоверность контента. Алгоритмы при этом используют совокупность разных сигналов.
Достоверность особенно важна в YMYL-темах — там, где материалы могут повлиять на финансы, здоровье и безопасность человека. Аккуратного текста здесь мало. Нужны проверяемые источники, прозрачное авторство, экспертная проверка, редакционная ответственность и своевременная актуализация.
Микроразметка автора или рецензента может помочь поисковой системе точнее понять страницу, но сама по себе она не доказывает экспертность. Разметить случайного копирайтера как Person проще, чем превратить его в врача или финансового аналитика.
Логика Google строится вокруг трёх вопросов:
- Кто создал контент и отвечает за него?
- Как были собраны данные, выводы и рекомендации?
- Зачем создана страница: решить задачу пользователя или собрать поисковый трафик любой ценой?
Почему непроверенный текст нейросети часто проигрывает
1. Модель уверенно галлюцинирует
Языковая модель не ищет истину — она предсказывает наиболее вероятное продолжение текста. Так и появляются несуществующие кейсы, перепутанные нормы права, мёртвые ссылки и вымышленные цитаты.
NIST называет это конфабуляцией: генеративная система создаёт ошибочную информацию, которая выглядит логичной и убедительной.
Рабочее правило: любая цифра, дата, цитата, правовая норма или YMYL-рекомендация, предложенная ИИ, считается непроверенной, пока редактор не сверит её с надёжным источником.
2. У нейросети нет практического опыта
ИИ может подробно описать банковский скоринг, процесс онбординга или работу отдела продаж. Но он не сидел на созвонах с интеграторами, не согласовывал тексты с комплаенсом и не видел, почему красивый процесс развалился после первого релиза.
Команда «добавь личный опыт» обычно рождает пластиковый сторителлинг. Чтобы текст жил, модели нужно передать реальную фактуру:
- результаты экспериментов и A/B-тестов;
- внутреннюю аналитику и разрешённые к использованию данные;
- расшифровки интервью с продуктовой командой;
- реальные ошибки, ограничения и неудачные гипотезы;
- комментарии профильных специалистов.
Без этого получается рерайт рерайта — аккуратный, гладкий и совершенно необязательный.
3. ИИ выдаёт усреднённые ответы
Модель склонна выдавать статистически вероятный, а значит, часто самый банальный ответ: «анализируйте целевую аудиторию», «создавайте качественный контент», «учитывайте потребности клиентов».
Такой текст может быть грамматически безупречным, но он не сообщает ничего нового ни для классического SEO, ни для генеративной выдачи.
Задача редактора — добавить то, чего обычно нет в ответе модели:
- контринтуитивные выводы;
- собственные данные;
- проверенные кейсы;
- авторские фреймворки;
- неочевидные ограничения метода;
- конкретные примеры применения.
4. Модель не несёт ответственности
Если в статье окажется опасный медицинский совет, неверное условие банковского продукта или ошибочная правовая рекомендация, отвечать придётся не чат-боту, а издателю и бизнесу.
Указывать GPT полноценным автором — плохая практика: модель не может подтвердить квалификацию, согласовать правки или нести ответственность за результат. Роль ИИ можно обозначить в редакционной политике, если это действительно важно для доверия аудитории.
5. Автоматизация масштабирует ошибки
Одна слабая статья — редакторская ошибка. Пятьсот слабых сгенерированных страниц — уже системная проблема, способная испортить качество целого раздела сайта.
Скорость публикации не должна превышать возможности команды по фактчекингу и редактуре. Генерация сама по себе не увеличивает производительность — иногда она просто быстрее создаёт очередь из непроверенных черновиков.
6. Возникают риски для комплаенса, NDA и авторских прав
Передавать публичным чат-ботам неанонимизированные клиентские базы, финансовые модели, внутренние документы или фрагменты проприетарного кода — прямой путь к утечке конфиденциальных данных.
Перед началом работы нужно понимать:
- какие данные разрешено передавать выбранному сервису;
- сохраняются ли запросы и ответы;
- могут ли они использоваться для обучения;
- есть ли корпоративная версия с подходящими настройками безопасности;
- требуется ли предварительная анонимизация информации.
Сгенерированный текст также нужно проверять на подозрительные совпадения и чрезмерное воспроизведение чужих формулировок — особенно если в контекст загружались материалы конкурентов или защищённые публикации.
Для каких задач ИИ действительно полезен
ИИ работает отлично, если использовать его как сильного ассистента, а не как самостоятельную боевую единицу. Он может:
- собрать кластер вопросов, связанных запросов и сущностей;
- предложить несколько вариантов структуры статьи;
- транскрибировать интервью и подготовить черновую выжимку;
- найти тавтологии и логические дыры в готовом черновике;
- переписать фрагменты, перегруженные канцеляритом;
- подготовить варианты Title и Description для редакторского отбора;
- собрать черновую микроразметку для последующей проверки SEO-специалистом;
- извлечь из текста утверждения, требующие фактчекинга;
- адаптировать готовый материал под другой формат или уровень подготовки аудитории.
Главное правило: чем точнее контекст, источники и ограничения задачи, тем меньше у модели пространства для галлюцинаций.
Просто загрузить материалы в промпт — ещё не полноценный RAG. Retrieval-Augmented Generation предполагает отдельный механизм поиска и извлечения релевантных данных из базы знаний. Но принцип тот же: модель должна опираться на контролируемый контекст, а не фантазировать на свободную тему.
Рабочий процесс: от идеи до публикации
Шаг 1. Сформируйте ТЗ до открытия чат-бота
Сначала определите рамки задачи:
- кто целевая аудитория и какой у неё JTBD — Job To Be Done;
- что пользователь уже знает о теме;
- какую задачу он хочет решить;
- какого целевого действия вы ждёте от читателя;
- что нового и полезного даёт материал;
- почему пользователь должен читать именно вас, а не первые три результата выдачи.
Промпт «напиши SEO-статью о ремонте» почти гарантированно выдаст банальность.
Запрос «собери гайд для владельцев квартир-студий площадью около 45 м²: объясни, как не выйти за смету при ремонте кухни, и разбери три частые ошибки на основе предоставленных нами данных» задаёт модели конкретный вектор.
Шаг 2. Соберите базу источников
Не поручайте модели абстрактно «найти исследования». Сначала соберите проверяемую базу:
- внутренние регламенты;
- PDF-отчёты;
- официальные документы;
- расшифровки интервью с экспертами;
- разрешённые выгрузки из аналитических систем;
- первичные исследования и статистику.
Попросите модель использовать только предоставленный контекст, а белые пятна отмечать тегом [НУЖЕН ИСТОЧНИК].
Шаг 3. Сначала архитектура, потом текст
На первом этапе генерируйте только структуру H2–H3 и требуйте объяснить:
- какой интент закрывает каждый раздел;
- где нужны графики, схемы или расчёты;
- где не хватает фактуры;
- есть ли смысловые повторы;
- какие вопросы пользователя остались без ответа.
Пересобрать скелет статьи дешевле, чем переписывать десять тысяч знаков готового текста.
Шаг 4. Собирайте материал итеративно
Не начинайте с команды «напиши исчерпывающее руководство». Генерируйте статью по разделам.
Утвердили H2 — подготовили фрагмент, проверили факты и логику, внесли правки, перешли дальше. Такой подход помогает не отклоняться от темы и не даёт тексту расползаться в бесконечные общие рассуждения.
Шаг 5. Добавьте реальную экспертизу
На этом этапе появляется мясо:
- собственные выводы;
- скриншоты из аналитики;
- данные компании;
- наблюдения специалистов;
- реальные кейсы;
- ограничения метода;
- ситуации, в которых совет не работает;
- позиция бренда.
Простой тест: если убрать название компании и текст без изменений подойдёт любому конкуренту, перед вами не экспертный материал, а универсальная заготовка.
Шаг 6. Проведите жёсткий фактчекинг
ИИ не может быть последней инстанцией при проверке собственного текста. Он способен найти подозрительные утверждения и составить список фактов для проверки, но может так же уверенно подтвердить собственную ошибку.
Извлеките из статьи:
- цифры;
- даты;
- имена;
- названия исследований;
- правовые и медицинские утверждения;
- причинно-следственные связи;
- цитаты;
- внешние ссылки.
Каждый значимый тезис нужно сверить с первоисточником. Ссылка, предложенная ИИ, считается проверенной только после того, как редактор открыл её, прочитал материал и убедился, что источник действительно подтверждает утверждение.
Шаг 7. Отредактируйте и высушите текст
Удалите:
- пластиковые вступления;
- абстрактные советы;
- псевдоэмоции;
- повторы;
- рекламный пафос;
- конструкции вроде «в современном быстро меняющемся мире»;
- англицизмы, которые ничего не добавляют к смыслу.
Оставьте факты, аргументы, ограничения и живой авторский голос.
Шаг 8. Добавьте SEO- и GEO-обвязку
Проверьте:
- Title и основной заголовок;
- соответствие поисковому интенту;
- связанные запросы и сущности;
- внутреннюю перелинковку;
- alt-тексты;
- прямые ответы на ключевые вопросы;
- логичность таблиц и списков;
- данные об авторе и рецензенте, если они действительно важны;
- корректность Schema.org;
- пользу, ради которой читатель перейдёт на сайт после краткого ИИ-ответа.
Как составлять промпты: инженерный подход
Промпт — это техническое задание, которое задаёт модели рамки. Чем жёстче рамки, тем чище результат.
Универсальный промпт для подготовки структуры
Ты — сеньор-редактор и исследователь. Задача — подготовить черновик.

Тема: [тема].
Целевая аудитория: [кто будет читать].
JTBD: [какую задачу решает пользователь].
Цель материала: [целевое действие].
Тон: [прямой, экспертный, без канцелярита и клише].
Уровень подготовки аудитории: [начальный / профессиональный].

Используй факты только из предоставленного контекста.

Zero Trust:
— не придумывай статистику, законы, исследования, цитаты и личный опыт;
— если данных не хватает, ставь тег [НУЖЕН ИСТОЧНИК];
— не маскируй предположения под факты.

Сначала:
1. Опиши интент пользователя.
2. Собери структуру H2–H3.
3. Перечисли фактические пробелы в контексте.
4. Укажи, где нужны примеры, таблицы или комментарии эксперта.

Жди согласования структуры. Полный текст пока не пиши.

Контекст:
[вставить проверенные материалы]
Проверка структуры
Проведи ревью структуры глазами требовательного и немного циничного читателя.

Для каждого H2–H3 укажи:
— какой интент он закрывает;
— что нового получает читатель;
— есть ли смысловые повторы между блоками;
— где необходимы данные, схемы, расчёты или первоисточники;
— можно ли удалить раздел без потери смысла.

В конце перечисли вопросы пользователя, которые структура пока не закрывает.
Семантика и связанные сущности
Перед тобой интент и кластер запросов.

Распредели запросы и связанные сущности по смысловым блокам статьи.

Не считай плотность ключевых слов и не вставляй неестественные точные вхождения.

Для каждого кластера укажи:
— интент;
— релевантный H2;
— связанные сущности, необходимые для раскрытия темы;
— нужен ли отдельный URL.

Отсей запросы, не соответствующие основному интенту страницы.
Подготовка фактчекинга
Ты выполняешь QA-проверку контента.

Извлеки из текста все утверждения, требующие подтверждения:
— цифры и метрики;
— даты;
— имена и названия;
— юридические, медицинские и финансовые утверждения;
— причинно-следственные связи;
— цитаты;
— результаты исследований.

Собери таблицу:
1. Утверждение.
2. Тип данных.
3. Указанный источник.
4. Что именно необходимо проверить.
5. Уровень риска: High / Medium / Low.

Не подтверждай факты самостоятельно и не придумывай источники.
Сушка и редактура
Проведи жёсткую редактуру текста.

Удали:
— воду и тавтологии;
— абстрактные советы;
— корпоративный буллшит;
— канцелярит;
— клише;
— натужные эмоции;
— повторы одной мысли разными словами.

Сохрани:
— факты;
— цифры;
— ссылки;
— примеры;
— ограничения;
— авторский тон.

Не придумывай новые факты и примеры.
Если тезис не подкреплён — поставь маркер [НУЖЕН ПРИМЕР] или [НУЖЕН ИСТОЧНИК].
Генерация метатегов
Подготовь 10 вариантов Title и 5 вариантов Description.

Требования:
— отражают интент и пользу материала;
— различаются по смысловому акценту;
— не используют кликбейт, ложную срочность и слова-пустышки;
— не обещают того, чего нет на странице;
— содержат цифры только в том случае, если они подтверждены в тексте.

Для каждого Title кратко укажи сильную и слабую сторону.
Оптимизация под AI Overviews и другие ИИ-ответы
Проанализируй текст и найди блоки, подходящие для Featured Snippets и ИИ-ответов.

Для каждого блока:
1. Определи конкретный вопрос пользователя.
2. Сформулируй прямой ответ в 2–3 предложениях.
3. Предложи подходящий формат: абзац, список или таблица.
4. Сохрани важные условия и ограничения.
5. Укажи, какую дополнительную пользу должен дать сайт, чтобы у пользователя была причина перейти.

Не упрощай ответ до потери смысла.
SEO-мифы, которые пора выкинуть из промптов
- «Вставь ключ в каждый H2». Это не гарантирует релевантность, зато легко делает текст неестественным и переоптимизированным. Работайте с интентом, вопросами и связанными сущностями.
- «Чем длиннее текст, тем выше позиции». У Google нет требований к объёму. Нужно 300 слов, чтобы полностью ответить на вопрос, — пишите 300. Не нужно выращивать статью до десяти тысяч знаков ради красивой цифры в ТЗ.
- «Пиши как сеньор-эксперт». Модель добавит уверенный тон и профессиональный жаргон, но реального опыта у неё от этого не появится. Экспертность рождается из фактуры, данных и практики, а не из фразы «ты — эксперт» в промпте.
- «Добавь FAQ и таблицу для красоты». Форматирование не превращает слабый текст в полезный. Таблица нужна там, где она упрощает сравнение, а FAQ — там, где закрывает реальные вопросы.
- «Проверил орфографию — можно в прод». Грамматика — это база. Главные риски — в фактах, логике, источниках и пользе материала.
- «Просто обнови дату». Замена года без пересмотра цифр, условий, ссылок и выводов — имитация актуальности.
PM-чеклист перед публикацией
- Материал точно отвечает на JTBD целевой аудитории.
- Все цифры, даты, цитаты и ссылки проверены по первоисточникам.
- Кейсы и примеры реальны, пластикового сторителлинга нет.
- Добавлена собственная экспертиза: данные, наблюдения, бенчмарки или комментарии специалистов.
- Указаны ограничения метода и ситуации, в которых он не работает.
- YMYL-контент прошёл проверку профильного специалиста, комплаенса или юриста.
- Запросы вписаны естественно, акцент сделан на смысле и связанных сущностях.
- Объём продиктован задачей, а не требованием «написать 10 тысяч знаков».
- Авторство и зона ответственности понятны читателю.
- Конфиденциальные данные не передавались публичным ИИ-сервисам.
- NDA, внутренние политики и требования к защите данных соблюдены.
- У пользователя есть причина перейти на сайт, даже если краткий ответ он уже получил от ИИ.
Вопросы и ответы
Наказывает ли Google за ИИ-тексты?
Не за сам факт использования ИИ. Но массовое производство страниц без самостоятельной ценности может нарушать политику Google в отношении масштабированного контента. Отдельный слабый материал может просто остаться незаметным в выдаче, а поточное производство такого контента создаёт риск для всего раздела сайта.
Нужно ли ставить плашку «Написано нейросетью»?
Google не требует универсальной маркировки каждого текста, созданного с помощью ИИ. Но стоит объяснить, как создавался материал, если это важно для доверия читателя: например, при генерации изображений, финансовых сводок, автоматических переводов или массивов данных. Отдельно нужно учитывать требования законодательства, отрасли и площадки публикации.
Можно ли опубликовать статью без редактуры?
Технически — да. Стратегически — плохая идея. Если текст не отвечает на интент, содержит ошибки и не сообщает ничего нового, он вряд ли надолго закрепится в поиске. В YMYL-тематике цена ошибки выше: на кону не только трафик, но и доверие, комплаенс и юридические риски.
E-E-A-T — это фактор ранжирования?
Нет, это не отдельный фактор. E-E-A-T — фреймворк для оценки опыта, экспертности, авторитетности и достоверности контента. Микроразметкой без реальной экспертизы эту систему не обмануть.
Какой объём текста нужен для топа?
Тот, который полностью закрывает задачу пользователя без повторов и воды. Ориентируйтесь на интент и сложность темы, а не на среднюю температуру по больнице у конкурентов.
Какая плотность ключевых слов считается правильной?
Универсального процента нет. Механический подсчёт плотности и попытки оптимизировать каждый абзац под точное вхождение давно не работают. Раскрывайте тему естественно — через вопросы, связанные термины и сущности.
Может ли ИИ самостоятельно провести фактчекинг?
ИИ может извлечь спорные утверждения, найти логические дыры и помочь составить план проверки. Но он не должен быть окончательным арбитром: модель способна с той же уверенностью подтвердить и собственную ошибку, и верный факт. Финальная проверка проводится человеком по первоисточникам.
Чем SEO-контент отличается от GEO-контента?
SEO-контент помогает странице занять заметные позиции и получать переходы из традиционной поисковой выдачи. GEO-контент дополнительно адаптирован для генеративных систем: содержит прямые ответы, проверяемые утверждения, понятную структуру и сведения, которые ИИ может корректно извлечь и процитировать. На практике хороший материал должен решать обе задачи одновременно.
Итог
Нейросети не создают плохой контент сами по себе. Они просто позволяют бизнесу производить его в промышленных масштабах.
Если процесс выстроен грамотно, ИИ забирает рутину: помогает обрабатывать источники, собирать структуру, работать с семантикой и находить слабые места. Смыслы, факты, реальный опыт и ответственность остаются за людьми.
Перед публикацией задайте один вопрос:
«Что действительно полезного пользователь найдёт здесь — и не найдёт в десятках нейро-рерайтов из топа?»
Если ответ есть — ИИ отработал как инструмент.
Если нет — перед вами просто аккуратно отформатированный черновик, которому пока рано в прод.